Kein Satz ohne Beleg: So hältst du Halluzinationen in Schach

Seit ChatGPT kann plötzlich jeder schreiben. Die Sätze sind grammatikalisch einwandfrei, und die Botschaften klingen überzeugend. Was an den Texten nicht stimmt, fällt den meisten erst später auf. Als Profi merkst du es natürlich sofort, und so wird dein Job zu dem, was du nie wolltest: Plötzlich bist du nicht mehr Texter, sondern Babysitter.
Das, was auf deinem Tisch landet, hat einen Namen: Slop. Laut Merriam-Webster ist es das Wort des Jahres 2025.1 Slop, das ist alles, was an KI-Texten nicht stimmt. Der Stil, den du nach drei Sätzen nicht mehr ertragen kannst. Und all die Aussagen, denen du nicht vertrauen kannst, weil du weisst: Alle klingen überzeugend, aber einige sind schlicht falsch.
Im Büro heisst es Workslop:2 Arbeit, die aussieht wie gute Arbeit, die Aufgabe aber keinen Schritt weiterbringt. Je besser die Sprachmodelle werden, desto schwieriger sind ihre Fehler zu erkennen. LLMs machen heute nicht weniger Fehler. Sie machen subtilere. Ein Satz klingt richtig, sitzt richtig, steht an der richtigen Stelle. Und stimmt nicht.
Wenn du als Profi gute Texte verantwortest, wenn es dein Job ist, dass nur gute Texte veröffentlicht werden, dann sitzt du zwischen den Stühlen. Neue Themen und neue Texte kommen schneller denn je, von Kollegen, vom CEO und von der Agentur, und an allen hat mindestens teilweise ein Chatbot mitgearbeitet. Auf der anderen Seite stehen die Fachexperten, diejenigen, die wissen werden, was an diesen Texten nicht stimmt. Und es muss dir peinlich sein, wenn du die Fehler nicht abfängst, sondern sie volley weitergibst. Irgendjemand muss sich gegen die Welle von Slop stellen. Entweder du tust es, und du leidest. Oder du gibst den Slop weiter, und das sollte dir peinlich sein.
Schlimm genug, dass die Menge Text immer weiter zunimmt. Du hast genug damit zu tun, dass die Texte so klingen, wie sie klingen sollen. Es darf nicht dein Job sein, Fakten hinterherzurennen. Bei keinem fremden Text, und fremd heisst in dem Fall: nicht nur von anderen Menschen, sondern auch von Maschinenwesen, also von allen Autoren, die nicht du selbst bist.
Gute Nachricht: Ob ein Text korrekt ist und sagt, was er sagen soll und sagen darf, das kannst du mit der KI prüfen. Nein, ein echter Faktencheck, wie ihn Journalisten brauchen würden, ist das nicht. Aber in der Markenkommunikation musst du ja auch nicht gegen die gesamten Fakten der gesamten Welt checken, sondern nur gegen die Aussagen, die der Konsens für deine Marke sind.
Hier in diesem Essay siehst du, was du mit den Bordmitteln von ChatGPT & Co. tun kannst. Und wie du mit speziellen Werkzeugen noch weiter gehen kannst: bis zu einem Claim Check, der jeden Satz gegen das prüft, was deine Marke schon gesagt und bestätigt hat.
Warum Sprachmodelle danebenliegen
Nimm eine Frage, an der Sprachmodelle gern scheitern: Wann darf ich Geld aus der Pensionskasse vorbeziehen? Ich habe sie 2024 für einen Workshop gewählt, und zwar mit Absicht. Schweizer Vorsorgerecht ist für ein Sprachmodell hartes Gelände.
Damals habe ich Perplexity gefragt. Die Antwort ist als nummerierte Liste gekommen, jeder Punkt der Liste mit Quellen. Einer der Punkte hat versprochen, ein Vorbezug gehe auch bei einer längeren Unterbrechung des Arbeitsverhältnisses. Beweisen soll diese Aussage angeblich ein Artikel von descartes.swiss. Genau dieser Artikel hat aber genau das Gegenteil gesagt: «Hier geht es nicht wirklich um einen Vorbezug der Pensionskasse, aber um ein Umparkieren.»3
Hat Perplexity diese Quelle also gelesen? Wer viele Quellen zitiert, hat die Quellen hoffentlich auch alle gelesen. Ob und wie gründlich, das siehst du der Antwort allerdings nicht an. Wenn du grenzenloser Techno-Optimist bist, dann könntest du beschliessen, dass das eigentlich eine gute Nachricht ist. Immerhin gibt es eine Quelle, und du kannst sie selber prüfen. Und wenn du genug Zeit aufwendest, siehst du, dass die Aussage nicht stimmt. Immerhin ist jetzt der Widerspruch klar.
Warum passiert so etwas? So verstehe ich es jedenfalls: Ein Sprachmodell lernt im Training aus riesigen Mengen Text, und es soll dabei gerade nicht an einzelnen Quellen kleben. Es soll verallgemeinern. Das macht es schnell: Es schöpft aus allem, was es je gelesen hat. Und so landen deutsche Regeln in Schweizer Texten. Normalerweise sieht man einem LLM nicht an, warum es etwas sagt und wie man das prüfen könnte. So gesehen ist Perplexity ein Schritt in die richtige Richtung gewesen. Eine Fussnote pro Aussage, damit du wenigstens weisst, wogegen du die Aussage prüfen könntest.
Angenommen, ich habe damals die Zeit nicht gehabt, jede der Quellen von Perplexity zu überprüfen, und habe deshalb im festen Glauben an belegte Quellen meinen Text geschrieben. Und in dem könnte dann ein Satz stehen wie dieser:
Was die meisten nicht wissen, die Pensionskasse kann man auch auflösen, wenn man sein Arbeitsverhältnis längere Zeit unterbricht – etwa während einer Mutterschaft.
Klingt kompetent. Ist falsch.
Die Stichprobe mit Bordmitteln
Wie kannst du so einen Satz abfangen, ohne dass du selber jede Aussage nachrecherchieren musst, und das in jedem fremden Text?
Keine Prüfung ohne Quellen. Jeder Text, der auf deinen Tisch kommt, sollte die Unterlagen mitbringen, auf denen er beruht. Sollte. In Wirklichkeit musst du das erst einmal durchsetzen, und ob du das kannst, hängt davon ab, wer dir den Text schickt. Vom Praktikanten verlangst du die Quellen. Vom CEO vielleicht eher nicht. Dann rennst du doch wieder den Fakten hinterher, nur nicht mehr Satz für Satz beim Redigieren. Du suchst einmal, vorher, die Quellen zusammen, die das ganze Thema abdecken.
Prüfen mit Bordmitteln. Dann prüfst du, ganz ohne besonderes Werkzeug. Du öffnest ChatGPT, Claude oder ein anderes Sprachmodell und fügst ein: den Entwurf, seine Quellen und eine Handvoll eigener Artikel zum Thema, die schon einmal durch eine professionelle Abnahme gegangen sind. Deine ganze Website passt da nicht hinein. Fünf bis zehn gute Artikel schon. Dann fragst du: Wo widerspricht der Entwurf diesen Unterlagen? Und was behauptet er, das nirgends steht?
Entscheiden mit Augenmass. Dann entscheidest du. Widerspricht eine Quelle dem Entwurf, geht der Satz zurück. Steht eine Aussage nirgends, fragst du nach, wer sie belegt. Und wo das Modell keine Fundstelle nennen kann, glaubst du ihm nicht, auch wenn es überzeugt klingt.
Genau das habe ich damals für den Workshop vorbereitet, mit fünf Artikeln aus der NZZ zur Altersvorsorge und dem Satz von oben.4 Dazu habe ich den Prompt nachgeschärft, weil ich misstrauisch gewesen bin: «Beantworte Fragen nach Fakten nur dann, wenn sie sich eindeutig aus den Anhängen der Wissensbasis ergeben.» Eine Frage ist damals offen geblieben, und ich habe sie mir so notiert: ob die Artikel die Antwort überhaupt enthalten haben, «oder ob diese Artikel nur dazu dienen ein Gefühl von Faktentreue zu vermitteln».
Im Oktober 2026 habe ich die Probe wiederholt: mit denselben Dateien, denselben Prompts und Claude in einer aktuellen Version. Zweimal, einmal mit den fünf NZZ-Artikeln und einmal zusätzlich mit dem Artikel von descartes.swiss. Ein Modell, ein Satz: eine Stichprobe der Stichprobe, kein Benchmark. Aber die alte Frage hat jetzt eine Antwort.
Ohne descartes hat das Modell meinen Satz «falsch» genannt. Begründet hat es das zum Teil mit seinem Fachwissen, und es hat dazugeschrieben, dass dieses Wissen nicht aus meinen Quellen stammt. Mit dem nachgeschärften Prompt hat es sein Urteil zurückgenommen: «durch die Wissensbasis nicht belegt». Mit descartes ist es beim Urteil geblieben, diesmal mit Zitat: widerlegt.
Gegen fünf Quellen schweigt die Wissensbasis, gegen sechs widerspricht sie. Und solange du das Modell nicht zwingst, mischt es die Quellen mit dem, was es sonst noch weiss.
Dabei ist noch etwas passiert: Gleich nachdem ich die Anhänge hochgeladen habe, hat das Modell sie zusammengefasst und den Fall bei descartes als Vorbezug aufgezählt, genau wie Perplexity zwei Jahre zuvor. Das Inhaltsverzeichnis des Artikels hat es nahegelegt: Dort ist der Unterbruch mitten in der Liste der Fälle gestanden, in denen ein Vorbezug möglich ist. Erst als ich ihm meinen Satz zum Prüfen gegeben habe, hat das Modell den Abschnitt selber gelesen und sich korrigiert. Wer nur die Liste liest, liegt daneben. Sprachmodelle wie Menschen.
Wenn du danach fragst, siehst du sogar, was das Modell geprüft hat. Ich habe beide Durchgänge gebeten, meinen Satz in seine Aussagen zu zerlegen und zu jeder die Fundstelle zu nennen. Beide haben es gemacht, sauber, mit Zitaten. Nur hat der eine Durchgang vier Aussagen gefunden und der andere sechs. Das Modell zeigt dir, was es diesmal geprüft hat. Was es beim nächsten Mal prüft, legt es nicht fest.
Was du mit ChatGPT & Co. machst, kann darum immer nur eine Stichprobe sein. Ein Sprachmodell liefert nie die vollständige Antwort: Mal ist die Antwort zu lang, mal zu kurz. Meine Erfahrung: Wer nach zehn Problemen fragt, bekommt zehn. Räumst du sie aus, bekommst du im nächsten Durchgang wieder zehn. Erfunden sind die späteren selten. Aufgeblasen schon: Ein Komma wird zum Risiko, eine Nuance zum Widerspruch.
Mach die Stichprobe auf jeden Fall, bei jedem fremden Text. Mit der Stichprobe fängst du, was krass falsch ist, etwa den Satz über die Pensionskasse. Was ihr durch die Lappen geht, weisst du leider nicht.
Warum können Programmierer automatisch schreiben, aber ich nicht?
Wenn du derzeit auf YouTube Videos von Programmierern schaust, dann brüsten sie sich gerade damit, dass sie abends ihre Agents starten: keine Chats, die auf die nächste Frage warten, sondern Programme, die selber arbeiten. Am Morgen ist der Gegenwert einer ganzen Arbeitswoche fertig und Teil des Produkts. Neue Funktionen entstehen wie von Zauberhand, und weil die KI sich selber prüft, scheinen Fehler gar nicht mehr möglich.
Versuch das einmal beim Schreiben. Lass über Nacht den Gegenwert einer Arbeitswoche entstehen. Am Morgen liegen fünf Blogposts da, zwanzig LinkedIn-Posts und ein Whitepaper. Alle grauenhaft. Vielleicht nicht offensichtlich falsch, aber grundsätzlich daneben und eine Zumutung für jeden Leser. Slop eben.
Ob es für die Programmierer wirklich so funktioniert, kann ich nicht beurteilen. Aber sie haben etwas, das wir beim Texten nicht haben, und darum habe ich sie beneidet: Tests. Kleine Programme, die prüfen, ob ein Programm tut, was es soll, immer wieder und ohne Diskussion. Läuft der Test durch, sagen sie, funktioniert die Software.
Und so erzählen sie es: Die Tests kann das Sprachmodell selber laufen lassen. Es schreibt Code, startet den Test, sieht den Fehler und bessert nach. Wieder und wieder, bis der Test durchläuft. Darum können die Agents über Nacht arbeiten, ohne dass jemand danebensitzt. Beim Schreiben fehlt genau dieser Test.
Ob die Software auch gut ist, sagt der Test allerdings nicht. Ob sie elegant ist, ob es mit weniger Code gegangen wäre: Geschmackssache. Beim Programmieren kann man darüber vielleicht noch streiten, der Code läuft ja unter der Haube. Beim Schreiben ist der Text das Ergebnis, und ob er sich gut liest, merken sogar Menschen, die selber nicht schreiben. Über den Stil reden wir in einem anderen Essay aus der Serie «Stop the slop». Heute geht es um die andere Hälfte des Problems, und die ist testbar: Was ein Text behauptet, kann man prüfen.
Den gründlichsten Ansatz dafür kenne ich von Microsoft Research. Er heisst Claimify5 und zerlegt einen Text in die kleinsten Aussagen, die man einzeln prüfen kann. Jede Aussage behält dabei so viel Zusammenhang, wie es für ein richtiges Urteil braucht. Aus einem kleinen Absatz wird ein ganzer Stapel Einzelteile. Gründlich. Aufwendig. Und Claimify beantwortet nur die halbe Frage: Jetzt weisst du, was geprüft gehört. Wogegen prüfst du es?
Testen wie ein Buchhalter: Kein Satz ohne Beleg
Die Antwort habe ich in der Buchhaltung gefunden.
Über die Buchhaltung gibt es Vorurteile. Langweilig. Pedantisch. Ein bisschen grau. Genau das macht sie stark. Sie hat einfache Regeln, und an die hält sie sich. Soll und Haben müssen aufgehen. Und keine Buchung ohne Beleg. Keine Spesen ohne Quittung.
Für Texte heisst das: kein Satz ohne Beleg. Ein Beleg ist eine Aussage, die in einen Text darf, zusammen mit den Quellen, aus denen sie stammt, dem Datum, ab dem sie gilt, und einer Bestätigung: wer sie bestätigt hat, und wann. Die Belege zu einer Sache bilden ein Thema, etwa den Vorbezug für Wohneigentum. Die Themen bilden ein Themenfeld, etwa die Pensionskasse. Und gegen diese Belege prüft der Claim Check jeden Text.
Ein Beleg sieht etwa so aus:
| Aussage | Für selbst bewohntes Wohneigentum kannst du Geld aus der Pensionskasse vorbeziehen. |
| Bedingung | nur für selbst bewohntes Wohneigentum |
| Quellen | die Seite der Marke zum Wohneigentum, dazu Art. 30c BVG und Art. 4 WEFV |
| Gilt ab | dem Datum der Quelle |
| Bestätigt | von der Fachexpertin für Vorsorge, bei der Durchsicht ihres Themas |
Hier liegt die Chance der Markenkommunikation. Wenn du als Journalist ein neues Thema recherchierst, dann musst du jede Aussage an der ganzen Welt messen. Wenn du die Geschichte deiner Marke erzählst, dann musst du nur sagen, was sie schon immer gesagt hat, oder das, worauf ihr euch strategisch geeinigt habt. Eine Marke muss die Welt nicht neu erfinden. Sie muss die richtige Auswahl treffen und sich selbst nicht widersprechen. Was eine Bank über ihre Hypotheken sagt, steht längst auf ihrer Website, in Kundenmagazinen, in Newslettern, oder die neue Strategie gibt es vor. Es gibt nichts zu erfinden. Darüber muss man nur Buch führen.
Ein Claim Check muss also keine Fakten checken, sondern nur die Aussagen, auf die sich deine Marke festgelegt hat. Belegt heisst dann: so, wie die Marke es schon gesagt hat. Steht in einem Beleg etwas Falsches, kommt der Text trotzdem durch. Darum bestätigen Fachexperten die Belege, bevor jemand schreibt.
Manchmal braucht ein Thema mehr als die Aussagen, die stimmen. Nimm das Beispiel vom Anfang. Zum Vorbezug hält das Thema etwa fest:
- Belegt: «Für selbst bewohntes Wohneigentum kannst du Geld aus der Pensionskasse vorbeziehen.»
- Nur mit Bedingung: «Du kannst Geld aus der Pensionskasse vorbeziehen.» Wofür, muss dabeistehen.
- Widerlegt: «Wer sein Arbeitsverhältnis länger unterbricht, kann die Pensionskasse auflösen.»
Die mittlere Zeile ist die heikle. Der Satz stimmt, solange die Bedingung dabeisteht. Lässt ein Text sie weg, muss der Claim Check das merken.
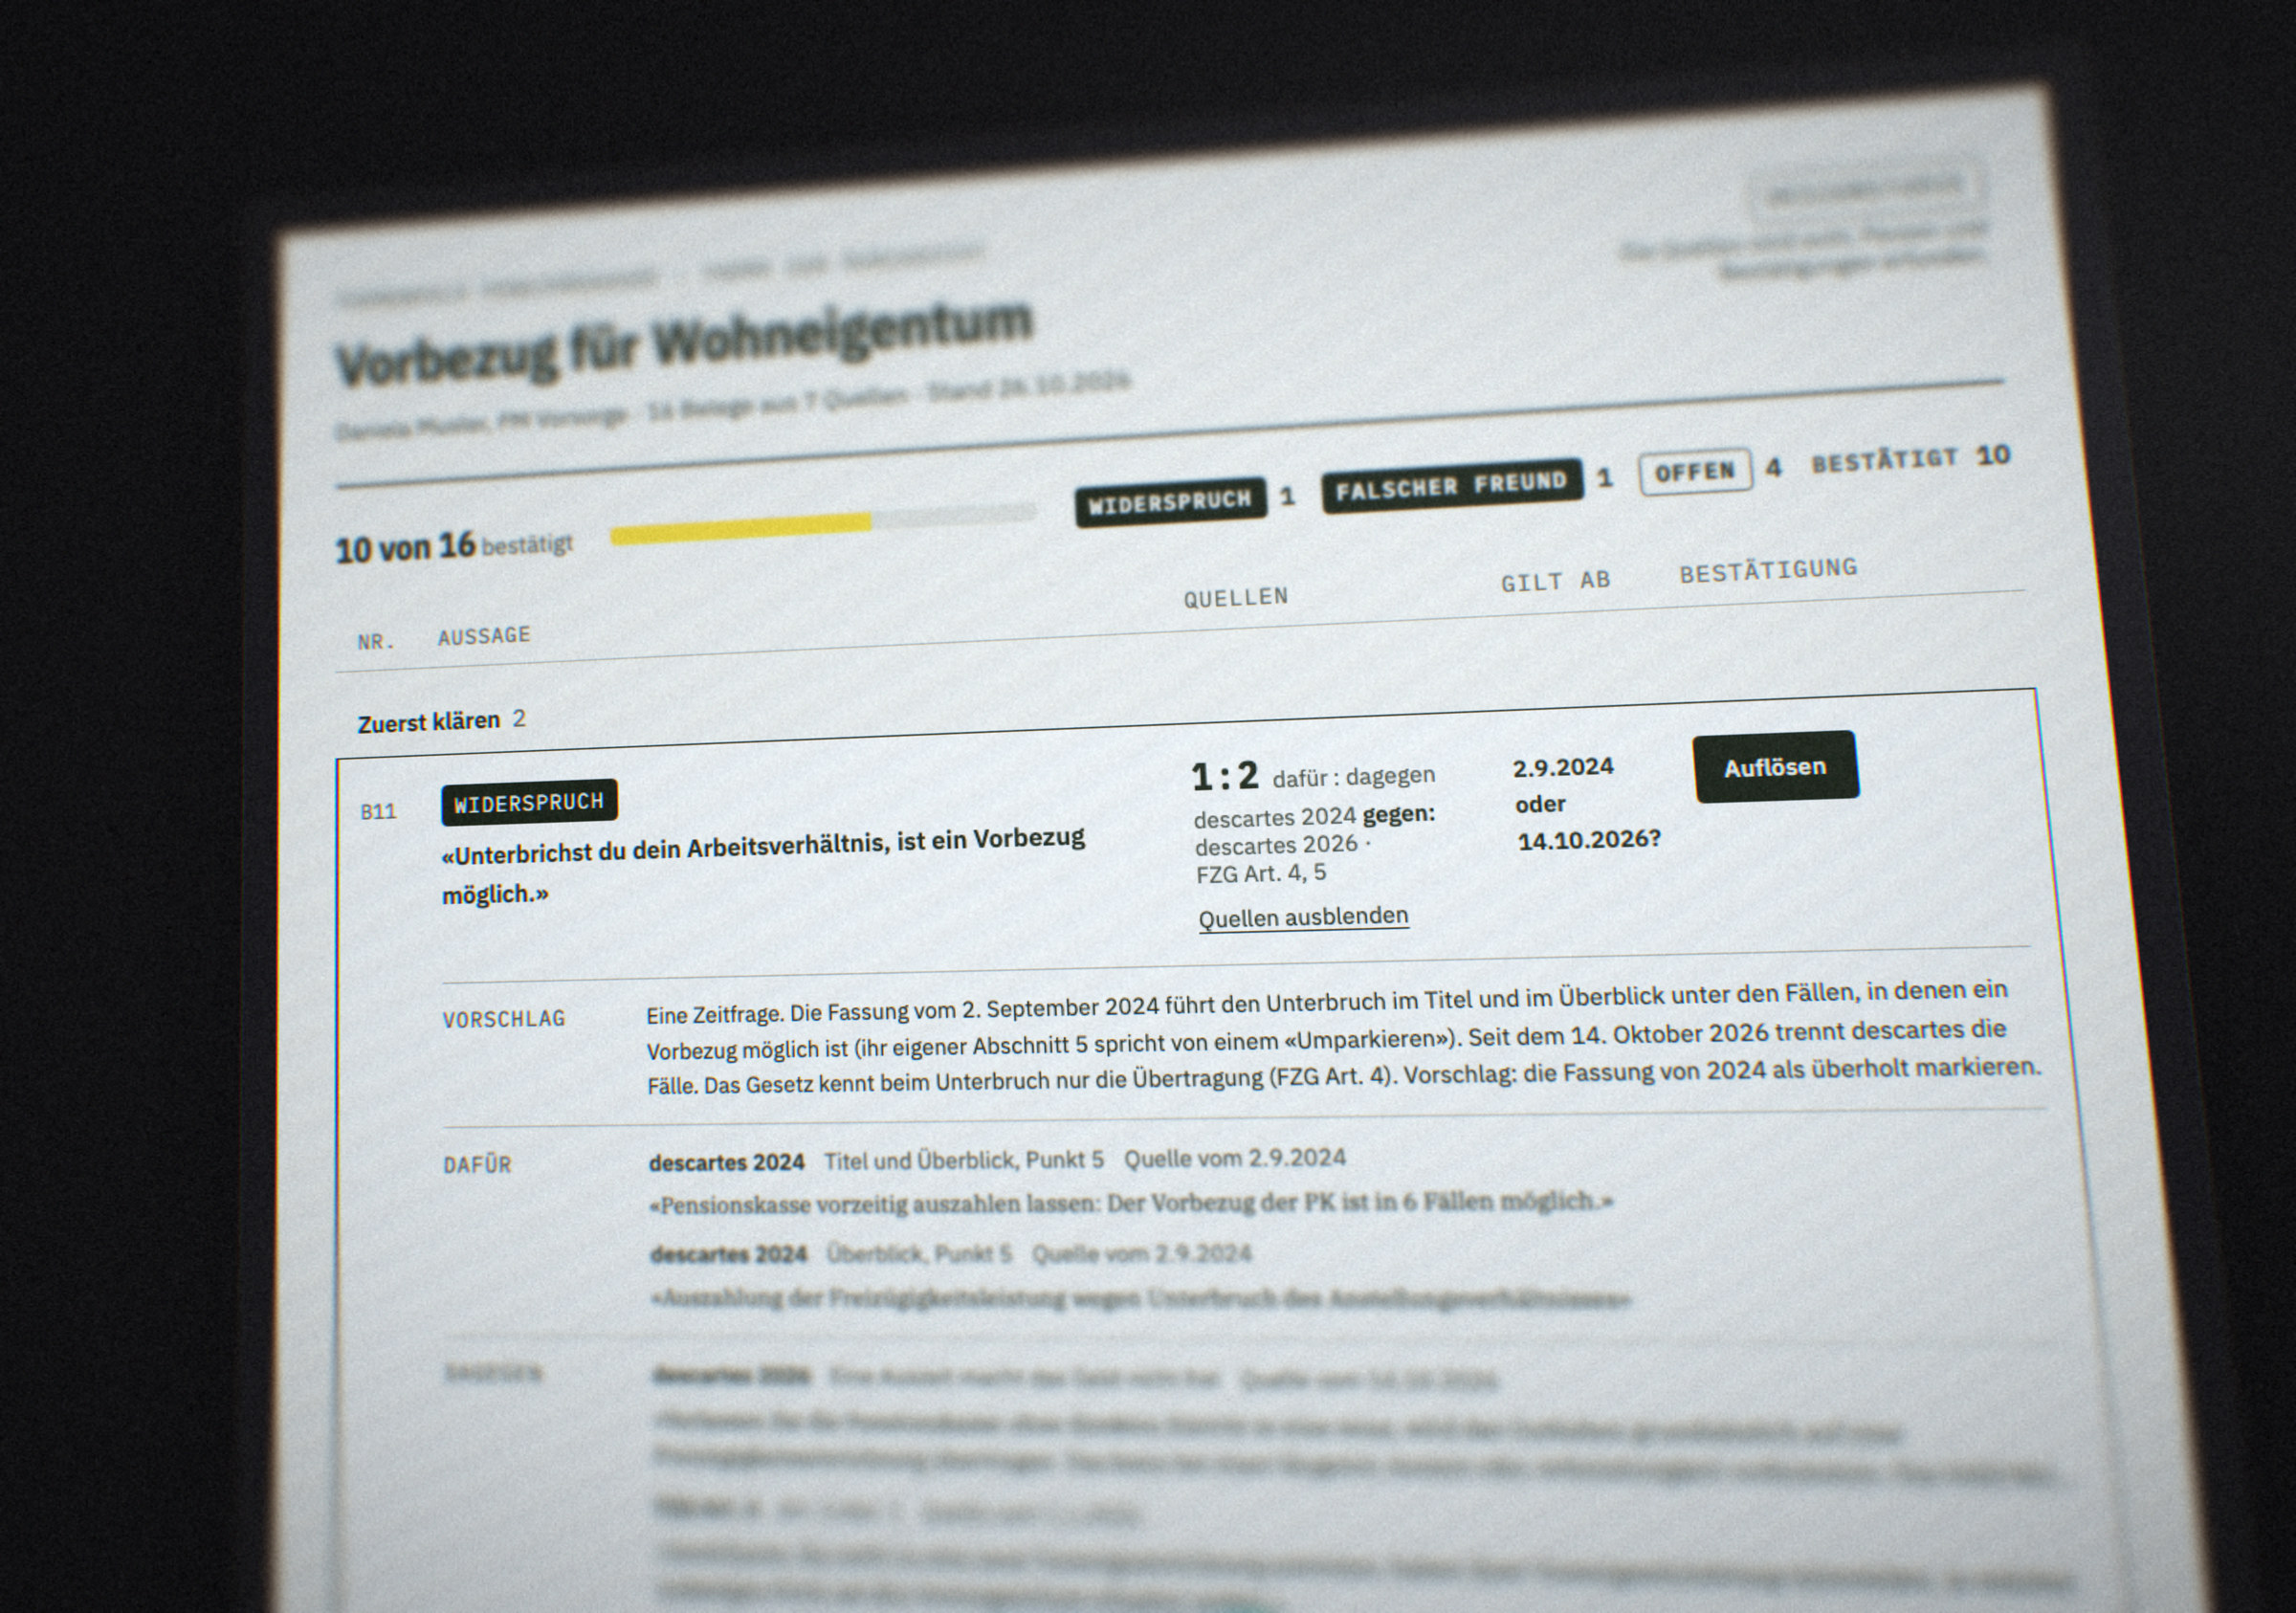
Besonders gefährlich sind die falschen Freunde: zwei Begriffe, die ähnlich klingen und Verschiedenes meinen. Bei der Pensionskasse sind das der Vorbezug und das, was descartes «Auszahlung der Freizügigkeitsleistung» genannt hat. Beim Vorbezug fliesst das Geld in dein Eigenheim. Bei dieser «Auszahlung» überweist die Pensionskasse es auf eine Freizügigkeitsstiftung, und frei verfügen kannst du darüber nicht. Genau diese Verwechslung ist Perplexity passiert, und zwei Jahre später dem Modell in meiner Wiederholung, in seiner Zusammenfassung. Eine Suche nach ähnlicher Bedeutung findet hier einen Treffer, wo keiner ist. Darum muss ein Mensch solche Paare sehen und entscheiden.
Erinnerst du dich an die zwei Urteile aus der Stichprobe, «nicht belegt» und «widerlegt»? Der Claim Check kennt dieselben zwei. Nur prüft er jeden Satz, nicht eine Auswahl. Findet er zu einem Satz keinen Beleg, ist der Satz nicht belegt. Sagt ein Beleg das Gegenteil, ist der Satz widerlegt. In beiden Fällen geht der Satz zurück. Braucht der Text die Aussage wirklich, bekommt sie zuerst einen Beleg, und eine Fachexpertin bestätigt ihn.
Auch Haltungen bekommen einen Beleg. Ob eine Bank die Einlagensicherung auf jeder Seite betont, entscheidet jemand, an einem bestimmten Tag, und steht dazu.
Wer Fakten checken will, muss die Fakten kennen
Bisher bist du den Fakten hinterhergerannt. Und jetzt musst du auch noch Buch führen und ausserdem Prüfungen abnehmen? Geht's eigentlich noch?
Nein. Wer Fakten checken will, muss die Fakten kennen. Aber das musst nicht du sein. Die Fakten kennen die Fachexperten, und sie geben sie einmal pro Thema weiter, an ein System, das schreibt und prüft. Du betreibst dieses System.
Die Werkzeuge dafür setze ich für Kunden schon ein. Für gtw.ai baue ich sie gerade so um, dass du sie selber verwenden kannst, und einiges entsteht erst dabei: die Schleife, die Fussnoten, die Oberfläche für die Bestätigung. Was ich hier beschreibe, ist das System, wie es gedacht ist.
Zuerst liest das System, was die Marke schon veröffentlicht hat: die Website, das Kundenmagazin, das Magazin fürs Personal, die Newsletter. Es zerlegt alles in Aussagen, mit demselben Verfahren, das es später auf jeden Entwurf anwendet. So vergleicht es Gleiches mit Gleichem.
Dann sortiert es, nach Themenfeld und Thema. Was zehnmal gleich dasteht, zählt es zusammen. Wo sieben Stellen das eine sagen und drei das andere, zeigt es den Widerspruch. Oft ist eine der beiden Seiten schlicht veraltet: Was vor fünf Jahren gegolten hat, gilt heute vielleicht nicht mehr, und darum bekommt jede Aussage ein Datum. Auch descartes hat den Artikel vom Anfang im Oktober 2026 überarbeitet. Heute steht dort: «Eine Auszeit macht das Geld nicht frei.» Wo zwei Begriffe gleich aussehen und Verschiedenes meinen, setzt es eine Markierung.
Dann bestätigen die Fachexperten, bevor jemand eine Zeile schreibt. Sie bestätigen kein einzelnes Dokument und keine einzelne Seite, sondern ihr Thema, als Ganzes. Die Subject Matter Experts sehen eine geordnete Liste, die Widersprüche und falschen Freunde obenauf. Das meiste haken sie einfach ab, nur die Zweifelsfälle brauchen ihr Urteil. Eine vorbereitete Sitzung pro Thema, dann steht es. Einzelne Rückfragen zwischendurch bekommen sie nie.
Dann wählt das System aus den Belegen aus, was auf welche Seite gehört, damit nicht auf allen Seiten dasselbe steht. Ob ein Argument trägt, entscheidet sich hier, bei der Auswahl.
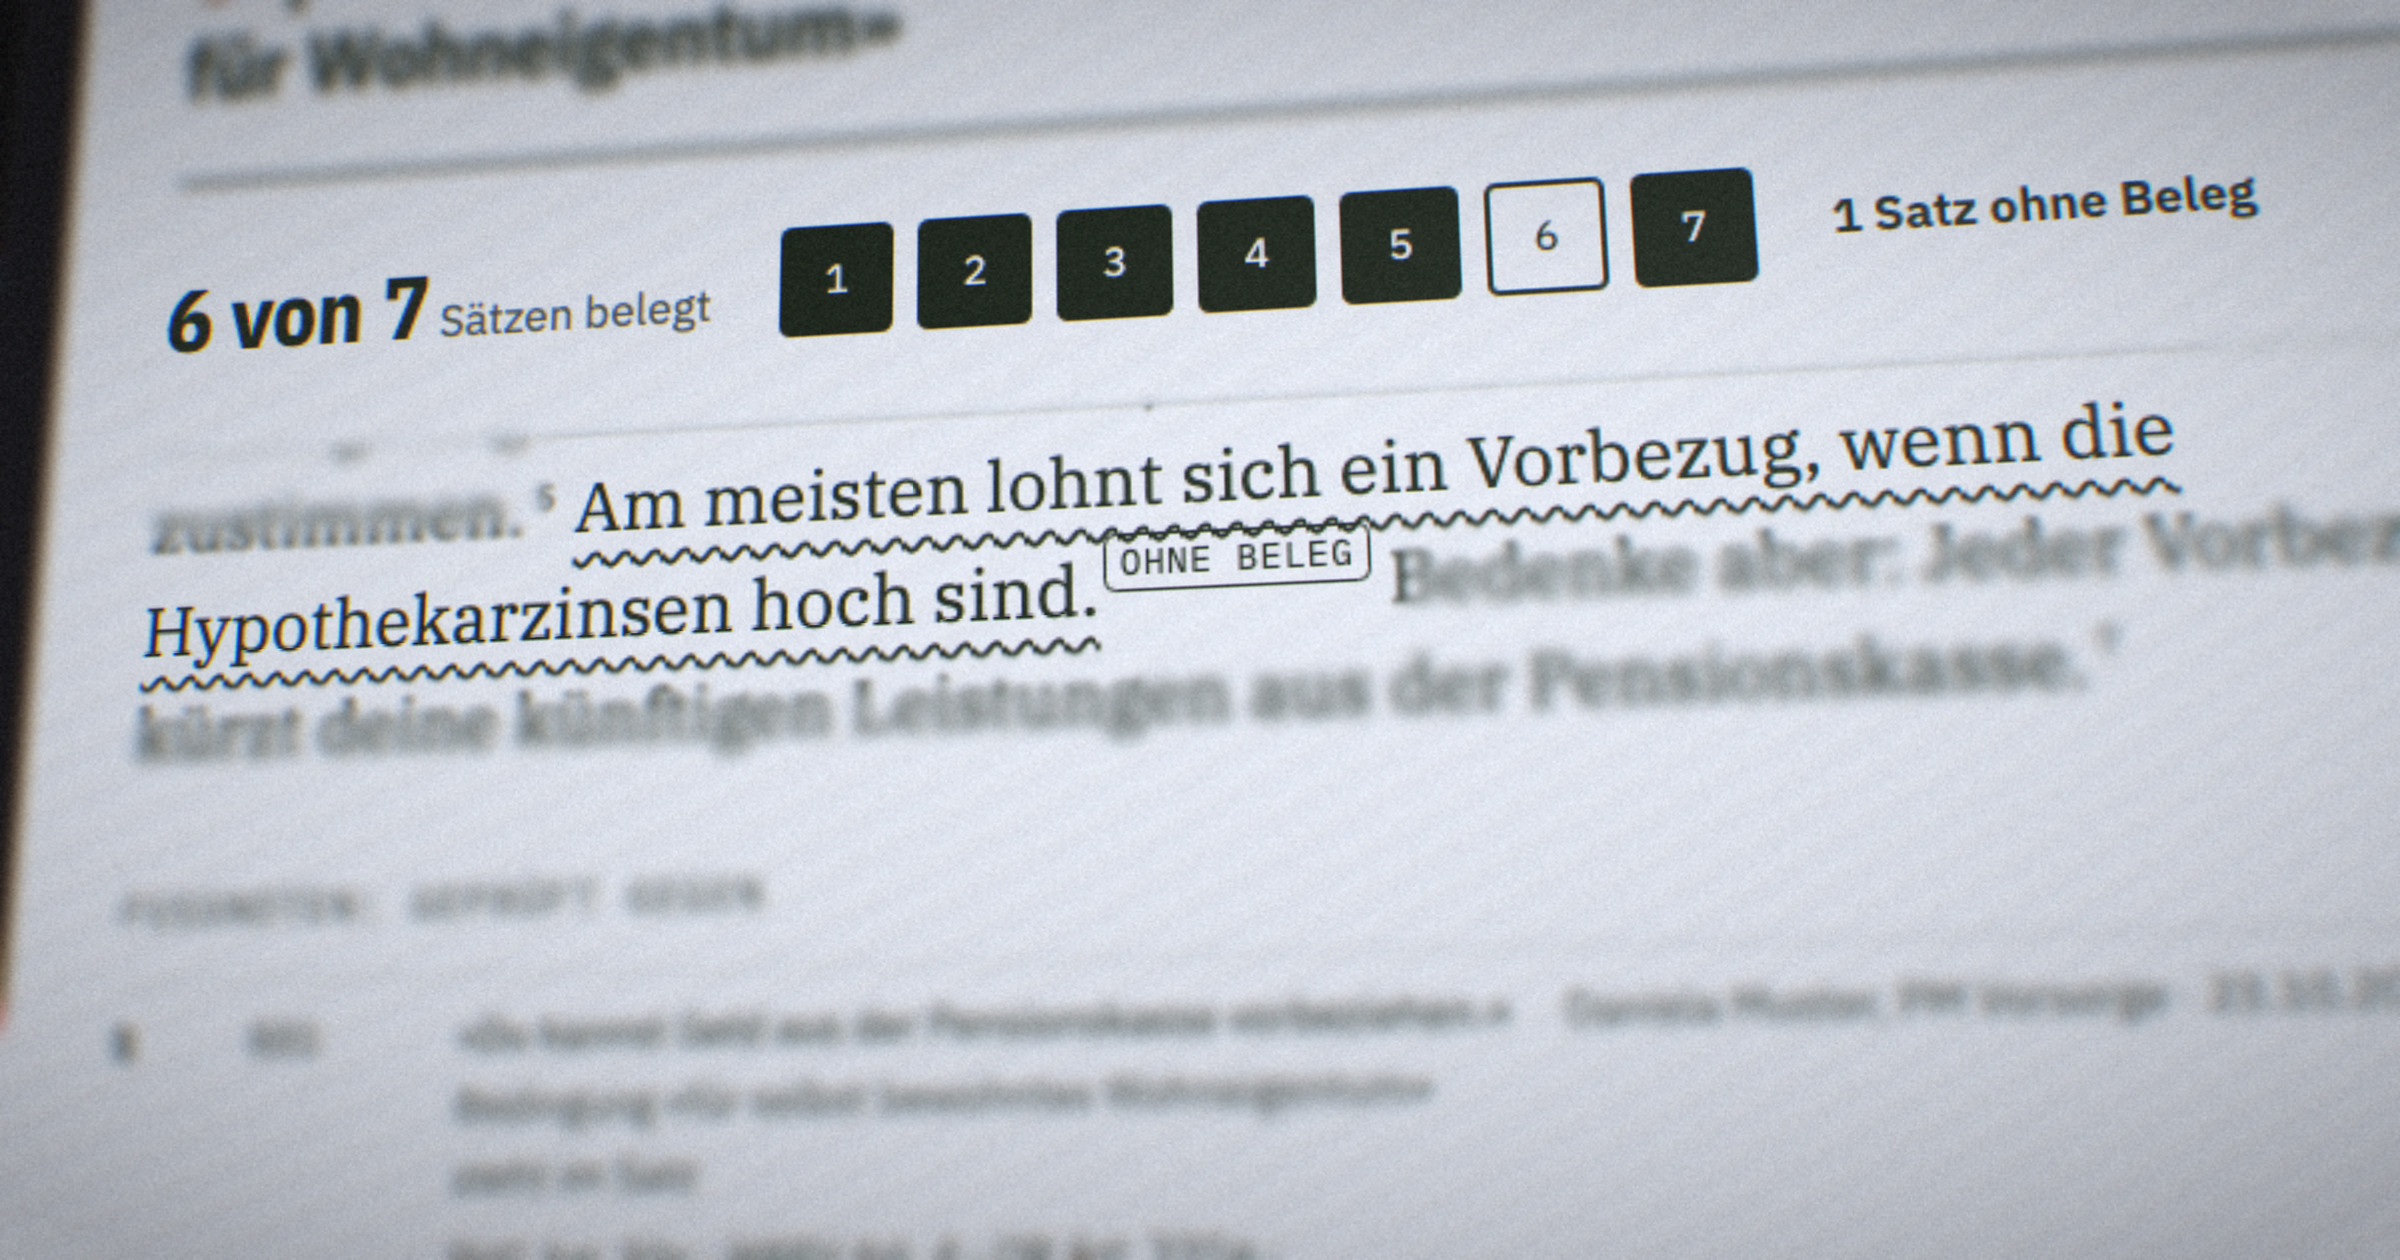
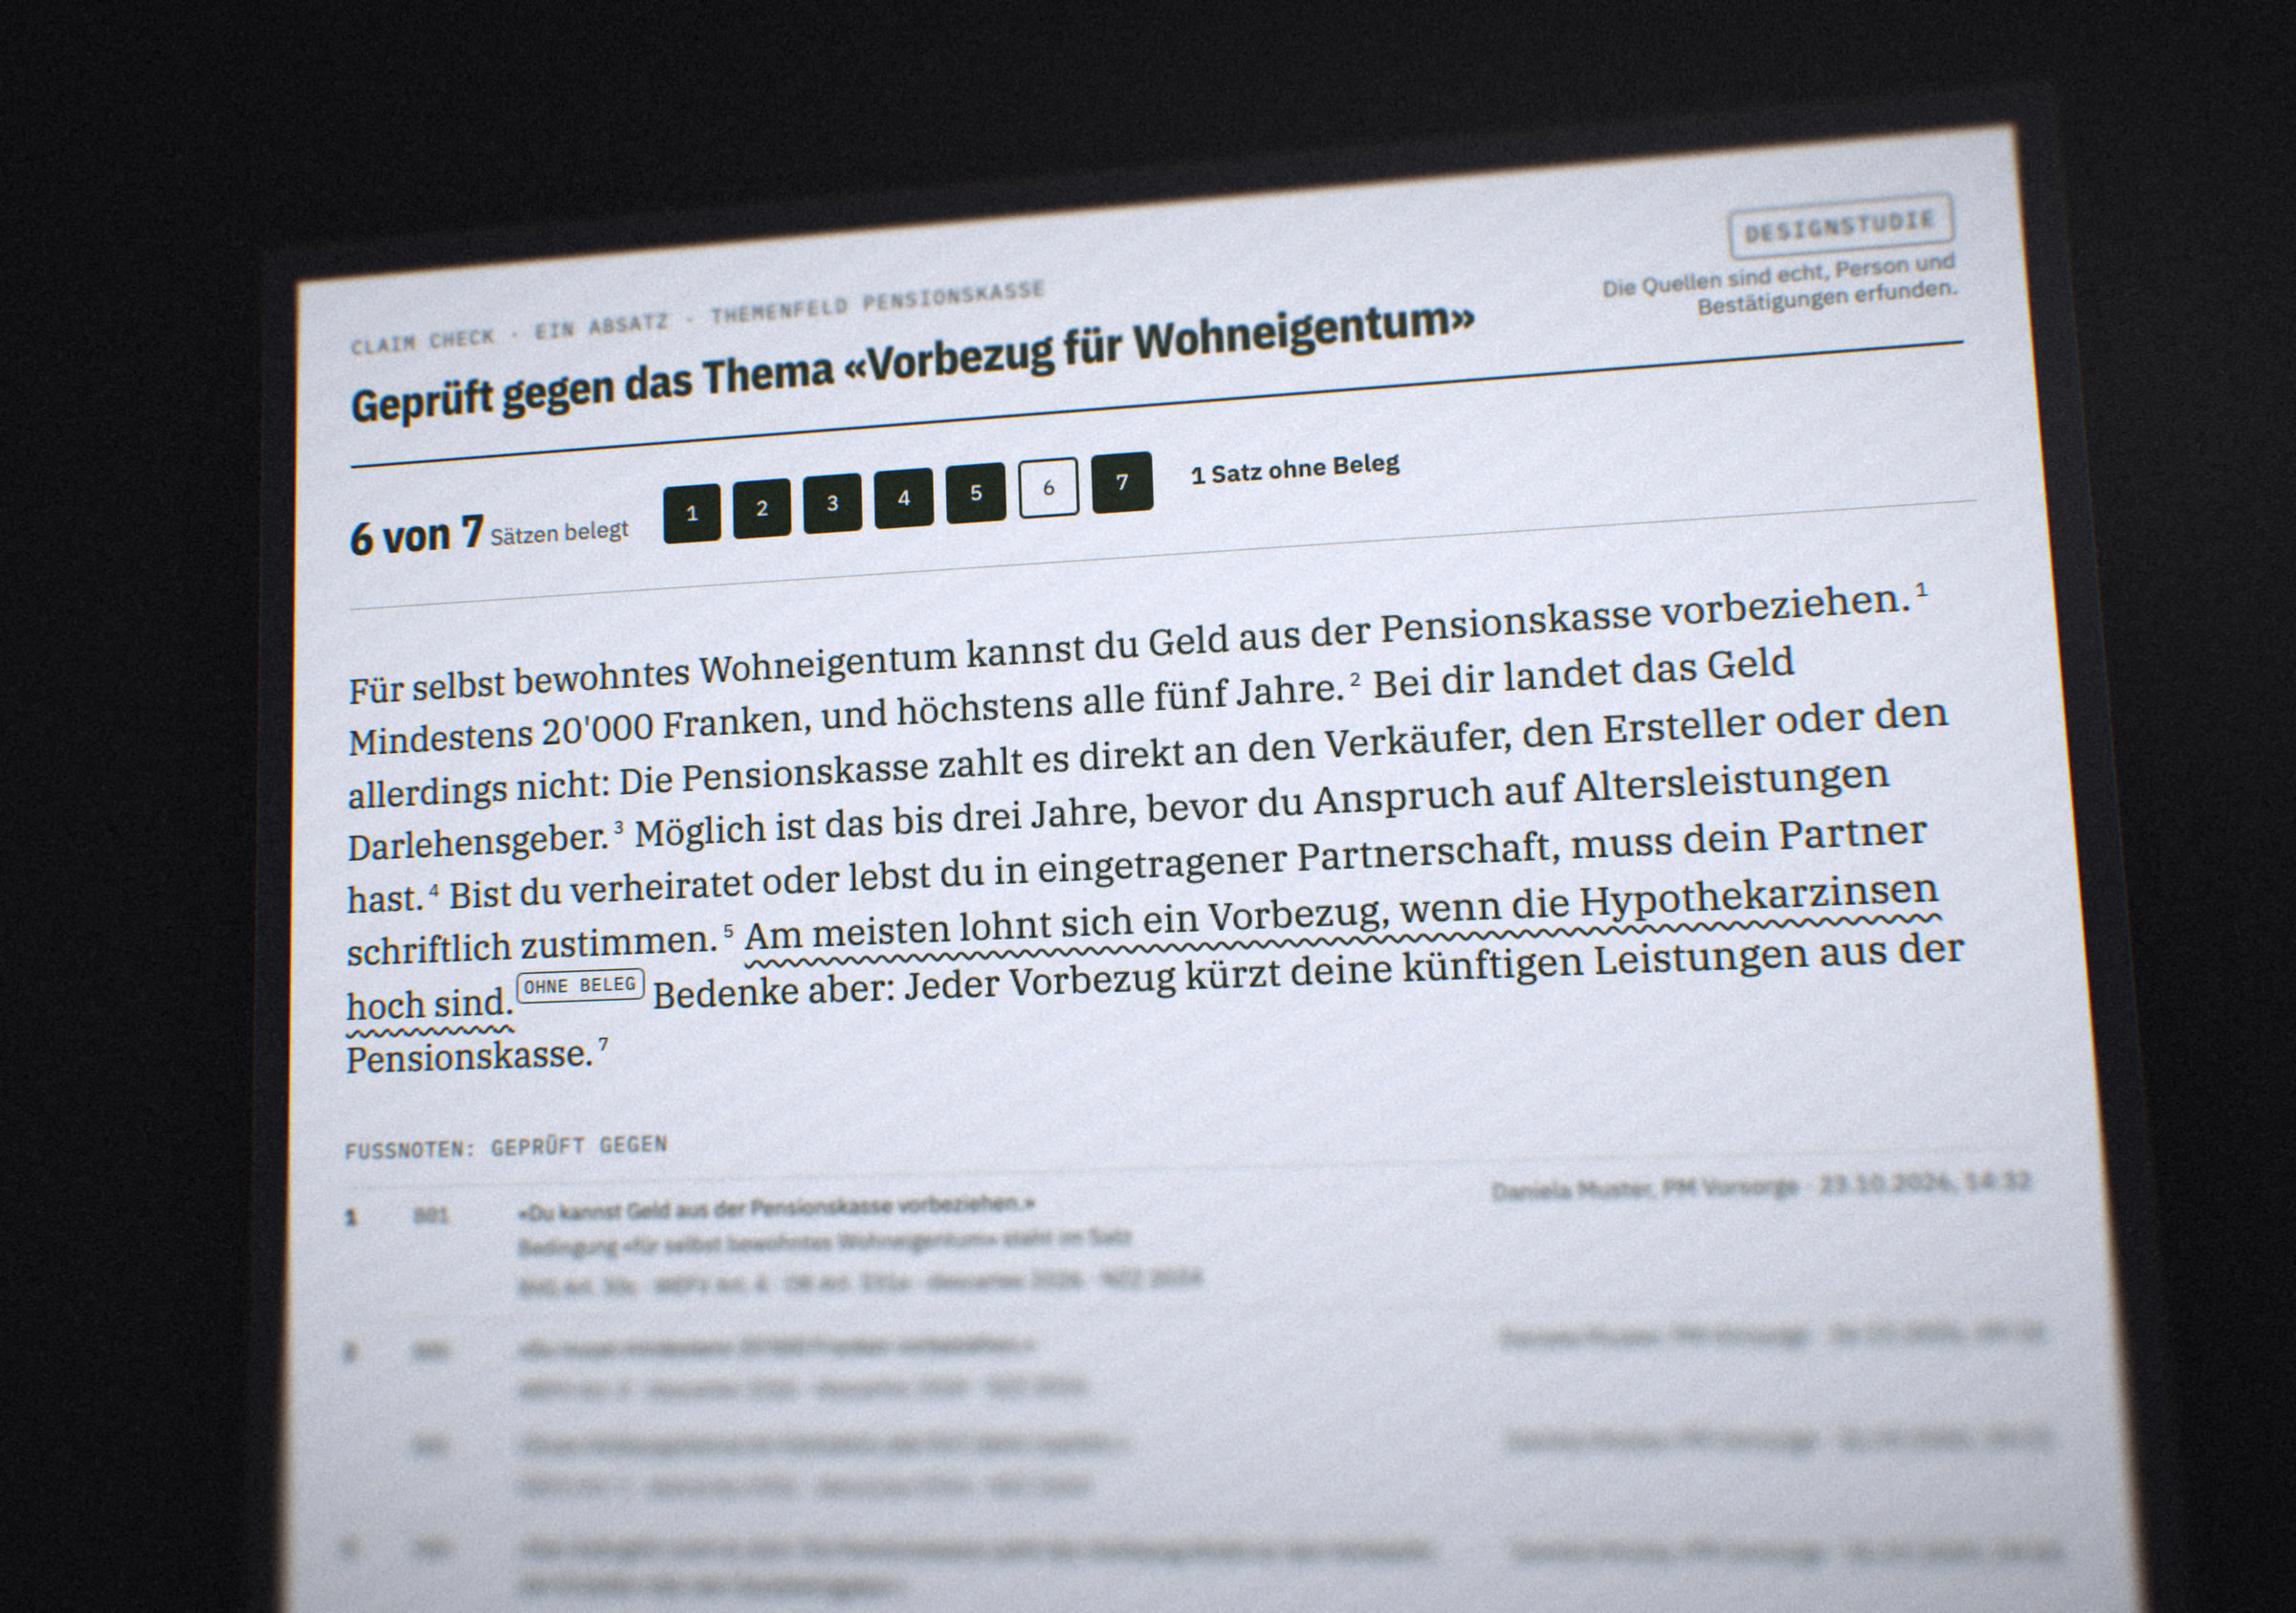
Dann schreibt es. Das Sprachmodell halluziniert. Das ist überhaupt nicht schlimm. Es lügt zwar ständig. Aber seine Lügen fliegen auf, bevor jemand sie druckt. Denn jetzt kommt der Claim Check. Er weiss schon vorher, was der Text sagen darf. Jeder Satz muss zu einem Beleg führen, und jeder Beleg, der auf diese Seite gehört, muss im Text stehen. Besteht der Entwurf nicht, geht er zurück, und das Sprachmodell bessert nach, so lange, bis er besteht. Jeder Satz bekommt eine Fussnote, die zeigt, gegen welchen Beleg das System ihn geprüft hat. Du musst nicht jede Fussnote nachlesen. Aber kein Satz rutscht ungesehen durch: Fehlt die Fussnote, siehst du es auf einen Blick.
Was die Schleife nicht klären kann, landet bei dir, denn du betreibst die Produktion. Das ist der einzige Moment, in dem du noch einzelnen Fakten nachspürst. Vieles klärst du aus Erfahrung. Den Rest klärst du mit den Fachexperten, so, wie es in deinem Team am besten funktioniert: jede Frage sofort einzeln, oder gelassener, einmal pro Thema, wenn alle Texte dazu fertig sind.
Und am Schluss kommst du noch einmal. Den Ton legen Vorlagen fest, und das Sprachmodell hat Beispiele bekommen. Du prüfst, ob der Stil sitzt, und setzt dem einzelnen Text das Sahnehäubchen auf: eine bessere Headline, einen Einstieg, der noch genauer zur Zielgruppe passt.
Das ist die Belohnung. Von den wenigen Eskalationen abgesehen, prüfst du keine Fakten mehr. Deine Zeit gehört dem Text.
Das Argument nach oben
Damit es so weit kommt, brauchst du ein Budget: Geld, oder Zeit, um es auszuprobieren. Die Geschäftsleitung brauchst du dafür nur, wenn du das Ganze als Projekt einkaufen willst, zum Beispiel bei Brained, wo ich diese Werkzeuge für Kunden einsetze. Bald stehen sie auch auf gtw.ai, zur Selbstbedienung.
Wer auch immer bei euch über das Budget entscheidet, vielleicht bist das du selbst: Sag zuerst, wie es dir geht und was das Problem ist. Dass du in Workslop ertrinkst und mehr Zeit damit verbringst, Fakten nachzurecherchieren, als mit Texten. Zähl dafür eine Woche lang mit: wie viele fremde Texte auf deinem Tisch gelandet sind und wie viele Stunden das Nachrecherchieren gekostet hat. Keine Hochrechnung, nur deine Woche. Dann erst die Methode, und dann die Bitte, in zwei Sätzen:
Entlastet mich davon, Workslop zu redigieren. Auf meinen Tisch kommt nur noch, was den Claim Check bestanden hat.
Was die Methode wirklich braucht, ist die Zeit der Fachexperten. Aber sie bündelt diese Zeit. Statt in zwölf Produktseiten über jeden Fehler einzeln zu stolpern, und zwar immer im falschen Moment, gibt es pro Thema eine Sitzung. Sie ist vorbereitet, die meisten Entscheidungen haken die Fachexperten einfach ab, und nur die Zweifelsfälle brauchen echten Input.
Und dann redigierst du wieder
Der Claim Check passt nahtlos in eine Produktion, die auch die Strategie, die Outline und das Schreiben der Texte automatisiert. Aber er gilt für jeden fremden Text: für den Text des Kollegen, den Entwurf des CEO und die Seite von der Agentur, jeder mit seinem eigenen Sprachmodell geschrieben, und für das, was dein eigenes Sprachmodell schreibt. Die Quellen, die du einmal für ein Thema zusammensuchst, werden Belege dieses Themas. Wer dir dann einen Text schickt, muss seine Unterlagen nicht mehr mitbringen. Sein Text muss gegen die Belege bestehen. Was besteht, bekommt deine Zeit. Alles andere geht zurück, bevor du anfängst. Dann redigierst du wieder als jemand, der schreibt: am Satz, am Einstieg, am Ton. Das Babysitten hört auf.
- Merriam-Webster: «2025 Word of the Year: Slop», 15. Dezember 2025, mit der Definition «digital content of low quality that is produced usually in quantity by means of artificial intelligence». Auch die American Dialect Society hat «slop» gewählt, das Macquarie Dictionary «AI slop». Ich fasse den Begriff hier weiter: Stil und unbelegte Aussagen. ↩︎
- Kate Niederhoffer, Jeffrey T. Hancock und ihr Team von BetterUp Labs und dem Stanford Social Media Lab: «AI-Generated "Workslop" Is Destroying Productivity», Harvard Business Review, 22. September 2025. Ihre Definition: «AI generated work content that masquerades as good work, but lacks the substance to meaningfully advance a given task.» ↩︎
- descartes.swiss: «Pensionskasse auszahlen lassen: Wann geht das?», Abschnitt 5, Fassung vom 2. September 2024 (archiviert). Am 14. Oktober 2026 hat descartes den Artikel überarbeitet; das Zitat steht dort nicht mehr. ↩︎
- Die fünf NZZ-Artikel, gespeichert am 3. September 2024: «AHV, Pensionskasse, Säule 3a: Wie man die Altersvorsorge optimiert», «AHV-Reform: Die wichtigsten Änderungen ab 2024», «Wohnung kaufen mit Pensionskassengeld und Säule 3a: Was man beachten muss», «Mit der 13. AHV-Rente werden Frühpensionierungen noch attraktiver», «Teure 13. AHV-Rente: Milliarden fliessen ins Ausland». ↩︎
- Dasha Metropolitansky und Jonathan Larson, Microsoft Research, 2025: Claimify auf arXiv. ↩︎